
Estos días, mientras buscaba información para preparar la presentación de una jornada, me encontré con una historia que me obligó a detenerme un rato.
Estaba repasando conceptos de anonimización, reidentificación y tecnologías de protección de la privacidad. Quería encontrar una manera sencilla de explicar algo que, sobre el papel, parece bastante evidente: eliminar el nombre de una base de datos no significa necesariamente que las personas que aparecen en ella hayan dejado de ser identificables.
Y entonces apareció el caso Sweeney.
No sé cómo había conseguido no prestarle la atención que merecía hasta ahora. Porque tiene todo lo necesario para una buena historia de ciberseguridad: una institución convencida de haber protegido los datos, una investigadora que desconfió de aquella seguridad y un desenlace tan sencillo como inquietante.
Lo mejor —o lo peor, dependiendo de cómo se mire— es que no hizo falta robar una contraseña, explotar una vulnerabilidad ni entrar ilegalmente en un servidor.
Bastaron tres campos de información y un registro electoral que costó 20 dólares.
Una base de datos sanitaria que, en teoría, ya no identificaba a nadie
Para entender la historia tenemos que viajar al Massachusetts de mediados de los años noventa.
La Group Insurance Commission (GIC), la comisión encargada de gestionar seguros para empleados públicos del estado, disponía de información sanitaria utilizada para estudiar la asistencia médica y sus costes. Como ocurre tantas veces en investigación, aquellos datos podían ser muy valiosos: permitían analizar patrones de utilización de servicios, diagnósticos y tratamientos.
La idea era facilitar su utilización para fines de investigación sin revelar la identidad de los pacientes.
Y, para conseguirlo, se eliminaron identificadores directos como el nombre, la dirección y el número de la Seguridad Social estadounidense.
Hasta aquí, puede parecer razonable.
Pero en los registros seguían figurando otros datos: el código postal, la fecha de nacimiento y el sexo, además de la información clínica.
El entonces gobernador de Massachusetts, William Weld, defendió públicamente que la privacidad había quedado protegida al retirar los identificadores.
Había un pequeño problema.
Que una base de datos no incluya nombres no significa que nadie pueda averiguar a quién pertenece cada registro.
Latanya Sweeney y una pregunta incómoda
Latanya Sweeney, por entonces estudiante de posgrado en el MIT, quiso poner a prueba aquella afirmación.
Su razonamiento fue tan simple como brillante: si una base de datos contiene datos demográficos que también aparecen en otra fuente, quizá sea posible relacionar ambas y descubrir quién hay detrás de un registro que parecía anónimo.
Sweeney sabía que el gobernador Weld vivía en Cambridge, Massachusetts. Por 20 dólares adquirió el registro de votantes de la ciudad, que contenía nombres y otros datos personales, incluidos la fecha de nacimiento, el sexo y el código postal.
Ahora tenía dos conjuntos de información:
- Registros sanitarios de la GIC: diagnósticos y otra información clínica, sin nombres, pero con fecha de nacimiento, sexo y código postal.
- Registro electoral de Cambridge: nombres y datos de los votantes, incluidos esos mismos tres campos demográficos.
Separadas, las dos fuentes parecían tener finalidades completamente distintas.
Juntas, permitían algo mucho más delicado.
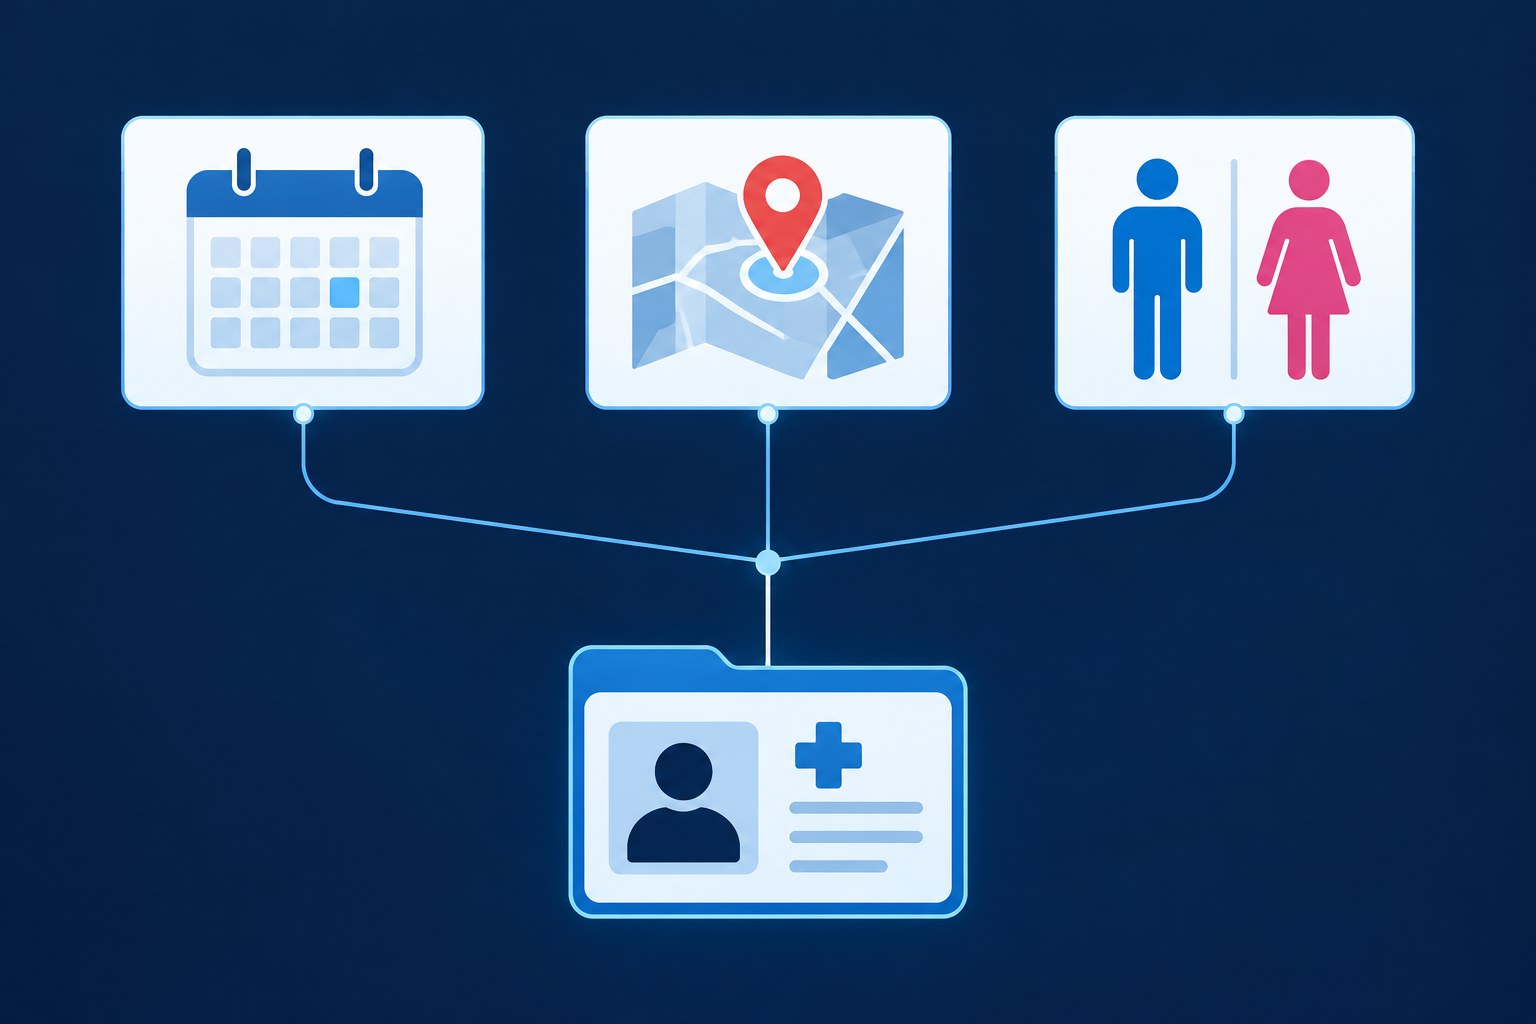
En protección de datos llamamos a esos atributos cuasiidentificadores: datos que quizá no identifiquen por sí solos a una persona, pero que pueden hacerlo al combinarse entre sí o con información adicional.
Seis personas. Tres hombres. Un único gobernador.
Y aquí llega la parte de la historia que me pareció especialmente impactante.
Según el relato del caso, en el registro electoral de Cambridge había seis personas que compartían la fecha de nacimiento de William Weld.
De esas seis, tres eran hombres.
Y, al comprobar sus códigos postales, solo uno de los tres vivía en el mismo código postal que el gobernador.
La combinación era suficiente para distinguirlo.
Fecha de nacimiento + sexo + código postal.
Tres campos que muchas organizaciones considerarían inofensivos cuando aparecen por separado.
Sweeney pudo relacionar aquella identidad con el correspondiente registro del conjunto sanitario y, como demostración, envió la información médica identificada a la oficina del propio gobernador.
Imaginemos por un momento la escena.
Una administración asegura que ha protegido la privacidad de sus empleados porque ha eliminado los nombres. Y alguien demuestra que puede reconstruir una identidad utilizando información disponible por otra vía.
Sin descifrar nada. Sin acceder a una cuenta ajena. Sin que el problema estuviera en una contraseña débil.
La vulnerabilidad estaba en la suposición de que los datos restantes no permitirían reconocer a nadie.
Conviene hacer una precisión: no fue un ataque reproducible sobre cualquier base de datos ni significa que cualquiera pudiera acceder a aquellos historiales. Sweeney necesitó disponer de los registros de la GIC y de una fuente auxiliar con atributos coincidentes. Precisamente esa combinación fue la que dejó al descubierto la debilidad del procedimiento.
El famoso 87 %: una cifra impresionante, pero que hay que explicar bien
El trabajo de Sweeney no se quedó en identificar al gobernador.
En su investigación Simple Demographics Often Identify People Uniquely, publicada como documento de trabajo en 2000, estudió hasta qué punto algunas combinaciones demográficas permitían distinguir a personas dentro de la población estadounidense.
Utilizando información del censo de 1990, estimó que el 87 % de la población de Estados Unidos podía quedar singularizada probablemente mediante la combinación de código postal de cinco dígitos, sexo y fecha completa de nacimiento.
87 %.
Es una cifra que sorprende, pero merece contexto. Se trata de una estimación histórica basada en unos datos y una metodología concretos, no de una ley universal ni de una prueba de que hoy pueda identificarse con certeza al 87 % de cualquier población. Singularizar a una persona tampoco equivale siempre a conocer automáticamente su nombre: para asociar esa combinación a una identidad puede ser necesaria otra fuente.
Y ese es precisamente el punto importante del caso.
La privacidad no depende únicamente de lo que contiene una tabla. También depende de qué otras tablas existen y de quién puede combinarlas.
Lo que nos enseña sobre anonimización y seudonimización
En muchas organizaciones todavía se escucha algo parecido a esto:
«No te preocupes, los datos están anonimizados: hemos quitado el nombre y el DNI».
Ojalá fuera tan sencillo.
El Reglamento General de Protección de Datos (RGPD) distingue entre la información verdaderamente anónima y los datos personales que siguen siendo atribuibles a una persona, aunque no aparezca directamente su identidad.
La seudonimización, definida en el artículo 4.5 del RGPD, es una medida de protección muy útil, pero los datos seudonimizados continúan siendo datos personales cuando pueden atribuirse a alguien mediante información adicional.
La anonimización persigue otro resultado: que la persona no sea identificable atendiendo a los medios que razonablemente puedan utilizarse, de acuerdo con el considerando 26 del RGPD.
El problema de los registros de Massachusetts fue que se retiraron identificadores directos, pero no se controló adecuadamente su capacidad de reidentificación por enlace con otros conjuntos de datos.
Y es importante no convertir el caso en una conclusión exagerada: no significa que anonimizar sea imposible. Significa que eliminar columnas no basta para demostrar que un conjunto de datos es anónimo. Hay que estudiar el riesgo real, el contexto de publicación, las fuentes auxiliares y los posibles avances tecnológicos.
¿Qué tiene que ver una historia de los noventa con la investigación sanitaria actual?
Muchísimo.
En investigación biomédica trabajamos con información cuyo valor científico puede ser enorme, pero cuya exposición también puede tener consecuencias importantes para las personas: enfermedades, tratamientos, episodios de hospitalización o características especialmente sensibles.
Imaginemos un estudio con registros de pacientes de una enfermedad poco frecuente. Se eliminan nombres, DNI y números de historia clínica. Sin embargo, el fichero conserva el año de nacimiento, el municipio, una fecha de ingreso muy concreta y algún dato clínico poco habitual.
Quizá ninguna columna identifique a nadie de forma aislada. Pero si esa información se cruza con una noticia local, una publicación en redes sociales o un registro accesible por otra vía, una combinación poco frecuente podría acabar señalando a una persona.
Este ejemplo es hipotético, pero el mecanismo es el mismo.
Además, el hecho de que una fuente sea pública o accesible no significa que su combinación con otras fuentes carezca de riesgos o de obligaciones jurídicas.
En los proyectos de investigación no basta con preguntar si hemos eliminado el nombre del paciente. También debemos preguntarnos si realmente necesitamos cada campo, con ese nivel de detalle, y quién podrá acceder a la información.
¿Cómo podemos reducir ese riesgo?
El caso Sweeney ayuda a entender por qué la protección de los datos no debe depender de una única medida.
Por ejemplo, podemos generalizar atributos: utilizar grupos de edad en lugar de fechas completas de nacimiento, o ámbitos geográficos más amplios en lugar de códigos postales detallados, siempre que el estudio lo permita.
También podemos suprimir combinaciones muy poco frecuentes, restringir el acceso a microdatos, utilizar entornos seguros de análisis y comprobar si los resultados que salen de esos entornos pueden revelar información individual.
Una técnica conocida es la k-anonimidad, que busca que cada combinación de cuasiidentificadores esté compartida por al menos k registros. Si se aplica con k = 5, por ejemplo, nadie debería quedar aislado en un grupo de un único registro al considerar esos atributos.
Pero tampoco es una solución mágica. Cinco personas con los mismos cuasiidentificadores podrían, por ejemplo, compartir un mismo valor clínico sensible; en ese supuesto, aunque no sepamos cuál es cada registro, podríamos descubrir algo sobre todas ellas. Por eso deben considerarse otros riesgos y medidas complementarias.
Y aquí entran en juego otras tecnologías que también estoy revisando para la jornada: las PET (Privacy-Enhancing Technologies), como el cálculo multipartito seguro y, en determinados escenarios, la privacidad diferencial.
También los enfoques federados pueden permitir que ciertos análisis se realicen sin concentrar todos los datos individuales en un único lugar. Pero federar datos no equivale automáticamente a proteger la privacidad: las estadísticas compartidas, los modelos, las consultas y los grupos pequeños pueden seguir filtrando información si no se diseñan controles adecuados.
La pregunta más útil no es «¿qué técnica está de moda?», sino «¿qué información necesita realmente este análisis y cómo evitamos revelar más de la necesaria?».
El verdadero problema nunca fue el nombre
Hay una idea de esta historia que no he podido quitarme de la cabeza desde que la descubrí.
Durante años hemos aprendido a reconocer los datos personales más evidentes: nombres, documentos de identidad, teléfonos o direcciones.
Pero el caso Sweeney demuestra que la identidad también puede aparecer por la combinación de piezas que, individualmente, parecen irrelevantes.
Y hoy esas piezas son mucho más abundantes que en los años noventa: registros abiertos, información comercial, publicaciones en redes sociales y enormes cantidades de datos que pueden procesarse y correlacionarse con facilidad.
La lección no es que debamos dejar de compartir información para investigar. Sería una conclusión equivocada, especialmente en el ámbito sanitario, donde el aprovechamiento responsable de los datos puede contribuir a mejorar diagnósticos, tratamientos y políticas de salud.
La lección es que compartir datos de forma responsable exige comprender también lo que pueden revelar cuando se combinan.
Y pensar que hemos protegido a alguien simplemente porque su nombre ya no aparece en una hoja de cálculo puede ser una manera bastante eficaz de llevarnos una sorpresa.
Preguntadle, si no, al gobernador Weld.
Fuentes y lecturas recomendadas
- Latanya Sweeney, Simple Demographics Often Identify People Uniquely (2000), Data Privacy Lab. Investigación original sobre la capacidad identificadora de los datos demográficos.
- Petrie-Flom Center, Harvard Law School: Law, Ethics & Science of Re-identification Demonstrations. Contexto y relato del caso de Massachusetts.
- AEPD: ¿Los datos anonimizados son datos personales? Criterio de identificabilidad y riesgo razonable de reidentificación.
- AEPD: Innovación y Tecnología. Guías sobre anonimización, k-anonimidad y privacidad diferencial.
- Reglamento (UE) 2016/679. Artículos 4 y 9 y considerando 26.
- Comité Europeo de Protección de Datos: Anonimización y seudonimización.